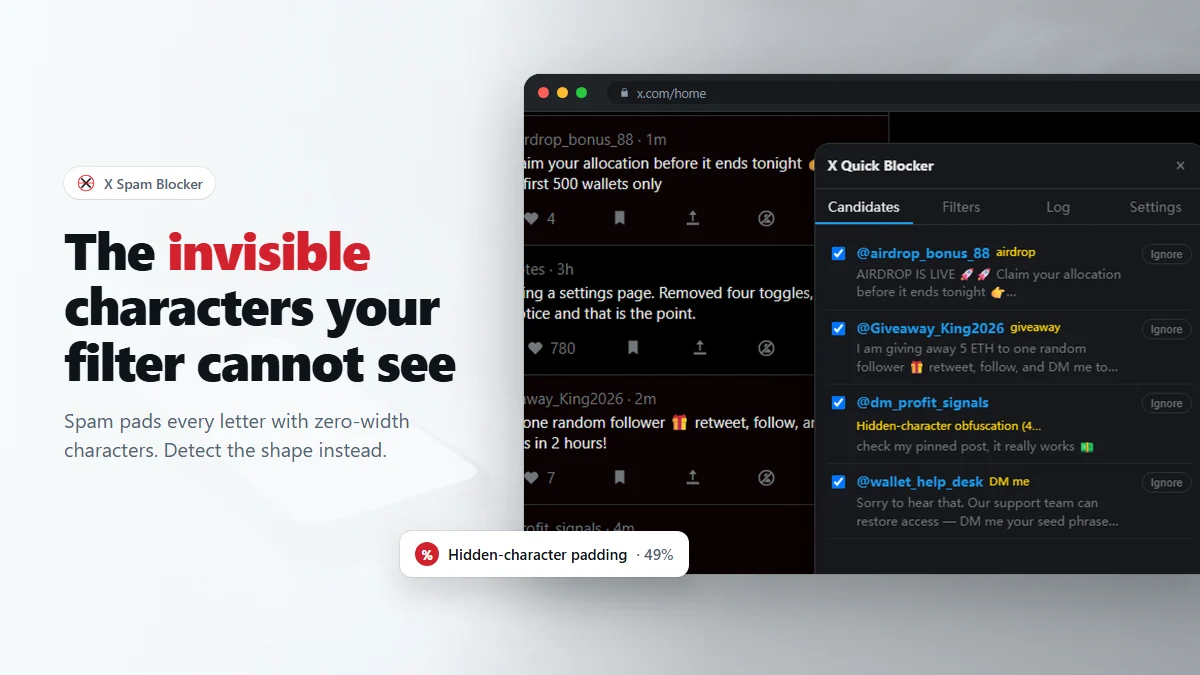
- 垃圾回复会在每个字符之间垫上看不见的零宽字符。屏幕上文字看起来正常,作为字符串却认不出来。
- 任何关键词或正则都匹配不上,因为你要找的短语已经不再连续。
- 办法有两步:匹配之前先剥掉隐形字符,另外再单独标出主要由隐形填充构成的推文。
- X Spam Blocker 两步都做。垃圾改写脚本之后,第二条规则仍然有效。
即便你什么都不安装,这一条也值得弄懂。它解释了几乎每个试图在 X 上过滤垃圾的人都会遇到的挫败:一条回复明明白白就是垃圾,肉眼也能看见过滤列表里的那个短语,过滤器却抓不住。推文没有骗你。你的过滤器看到的字符串,和你眼睛看见的不是同一串。
症状
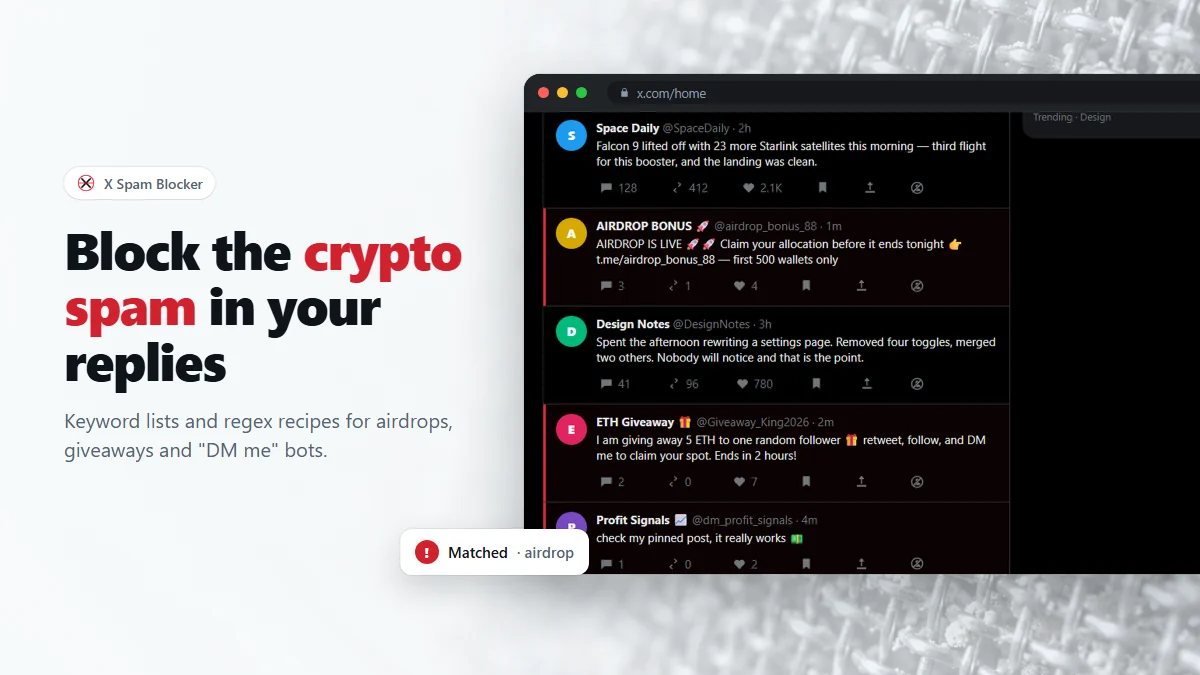
假设关键词列表里有 looks better than me,这时来了一条回复,屏幕上明明白白写着 nobody looks better than me。过滤器没有命中。你检查拼写,也检查扫描是否开着。你把推文里的文字复制出来,贴进关键词列表,这样也不行。事实上,现在什么都匹配不上了。
到了这一步,解释几乎总是填充。看得见的文本和底层文本不是一回事;你复制推文时,把填充也一起复制走了。
这种手法怎么运作
Unicode 里有一批故意看不见的字符。它们的工作不是被看见:把两个表情连成一个、告诉某种文字相邻字母该如何连接、标记文字方向的变化。它们渲染出来是空白,不占宽度,复制粘贴也能留下来。
于是垃圾号在消息的每个字符之间插入一个。八个字符的短语变成二十五个字符的字符串,其中十七个看不见。对读者来说它是八个字符。对过滤器来说,你的关键词里没有任何两个字母是相邻的。
| 看得见的 | 实际字符 | |
|---|---|---|
| 读者看见的 | 8 | — |
| 过滤器读到的 | 8 | 25 个,其中 17 个看不见 |
| 含有你的关键词吗? | 是 | 否 |
这对垃圾号没有成本,就是在发布回复的脚本里做一次查找替换,却能一下子击败每一种天真的过滤。
涉及哪些字符
从正在流通的回复垃圾里取样,填充几乎总是下面三个之一,还会轮换,以免看起来太机械:
| 码位 | 名称 | 正当用途 |
|---|---|---|
| U+200C | 零宽非连接符 | 在波斯文、阿拉伯文、天城文里阻止字母连写 |
| U+200D | 零宽连接符 | 把表情连成一个字形,例如家庭或职业 |
| U+2060 | 单词连接符 | 禁止换行,同时不插入空格 |
同一族里还有其他字符:字节顺序标记 U+FEFF、方向标记 U+200E 和 U+200F、软连字符 U+00AD、蒙古文元音分隔符 U+180E,以及 U+202A–U+202E 范围内的双向覆盖符。彻底的过滤必须把它们全部算进去,因为漏掉哪一个,下一个被用上的就是哪一个。
花 20 秒自己看一看
这件事不需要任何工具。打开一条垃圾回复,选中文字,复制,贴到一个能告诉你长度的地方。浏览器控制台最方便:
const s = `paste the copied reply here`
console.log(s.length)
console.log((s.match(/[--]/g) || []).length)正常句子的第二个数字是 0。带填充的垃圾会返回一个接近第一个数字的值。在一条取样的讨论串里,11 条回复中有 4 条各自带了 52 到 67 个隐形字符,大约是原始字符串的 80%,另外 7 条测出来正好是 0。中间没有灰色地带,这正是它能被识别的原因。
为什么文本过滤都会在它上面失败
这一点值得说精确,因为失败并不是某一款过滤的故障。三种防线会同时垮掉:
- 精确关键词。 立刻失效。那个子串并不存在。
- 「松」的正则,允许字符之间有空隙,比如
b.{0,3}e.{0,3}t。每个空隙能扛住一个填充字符,到六个就死。 - 复制来的关键词。 从垃圾里把短语复制出来,会连填充一起带来,于是你的新关键词只匹配那一条推文、那一种填充排列。
还有第四种容易漏掉的失败。在 JavaScript 里,像 .{0,3} 这样的量词数的是 UTF-16 码元,不是字符,而一个表情是两个码元。所以一条写成能容忍三个字符空隙的松正则,实际只能容忍一个表情。这也是用表情把词拆开、同样能击败松模式的原因。
办法一:匹配之前先剥掉这些字符
正确的解决位置,是在任何规则运行之前。X Spam Blocker 会为即将匹配的文本做一份清理后的副本:去掉隐形字符,再做 Unicode NFKC 规范化,让全角、带圈和上下标字母折回普通字母。然后它再做第三份更紧的副本,去掉所有空格、标点和表情,只留下字母和数字。
规则会对三份都试一遍,你的关键词也会按同样的方式规范化。这带来三个有用的结果:
- 你现有的关键词列表,不用改任何东西,就会开始对带填充的垃圾生效。
- 你从垃圾回复里复制出来的关键词,连填充一起,仍然能当过滤用。
- 用表情把词拆开,也就是那种能击败松正则的变体,由那份更紧的副本处理,它会把表情整个丢掉。
页面上的内容不会被修改。清理只作用于用于匹配的那份副本。
办法二:识别形态,而不是词语
剥掉能解决今天的垃圾。它解决不了下个月的,因为措辞会变,你的关键词列表还没跟上。所以还有第二条独立的规则,完全不看措辞:
如果一条推文里至少有 30% 的字符是可疑的隐形字符,并且至少有 6 个,推文还至少有 8 个字符,就标出它。不需要关键词。
整条规则就是这样。它的价值在于,大量隐形填充本身就是垃圾信号。没有人会写出一条正常推文,其中三分之一是隐形字符。实测差距非常大:取样的垃圾回复在收窄后的字符集上得分是 53% 到 60%,普通推文是 0。30% 的阈值坐在一条很宽的空白带中间。
在面板里,它就是同时识别用隐形字符填充的推文这个开关,默认开启。触发时,候选和日志会写成「隐形字符混淆」,并带上测得的百分比,方便你把它和自己的关键词区分开。关键词命中优先,所以两边都会触发时,你得到的是那个具体的词。调试规则时,这更有用。
表情带来的问题,以及为什么这条规则比看起来更窄
下面这一段决定这种规则是成立还是垮掉。零宽连接符 U+200D 不只是垃圾工具,它也是组合表情里的胶水。一个家庭表情是三个看得见的人,由两个 U+200D 连起来。天真地去量,会得到 40% 的隐形字符:在能想象到的最无辜的推文上出现一次误报。
所以识别规则使用的字符集,故意比剥除时用的更窄。有整整三类不计入证据:
- U+200D,零宽连接符,因为组合表情里到处都是它。
- U+FE00–U+FE0F,变体选择符,就是让 ❤️ 显示成彩色的那个隐形字符。
- U+E0020–U+E007F,标签字符,用于分区旗帜,例如 🏴。
去掉这三类之后,填充垃圾的得分仍然在五十几的高段,因为单靠 U+200C 和 U+2060 就足够定罪。对照表情家庭序列、彩色爱心、彩虹旗、职业表情、分区旗帜、把 U+200C 用作真正正字法的波斯文,以及故意垫得很短的推文做过验证,它们测出来都是 0.0%。
如果你要做类似的东西,这个取舍值得照抄:剥除规则可以贪心,因为多剥一次没有代价。识别规则必须吝啬,因为一次误报代价是一个真实账号。
既然看到这里,再说说相关手法
隐形填充是最常见的规避,但不是唯一的。同一套规范化能处理这一族里的大部分:
- 全角和装饰字母。 全角的 Fullwidth 文本、带圈字母、数学粗体,在 NFKC 下都会折回普通字母。
- 用表情当间隔。 一个词的字符之间插入表情。更紧的那份副本会把它们删掉,从而解决。
- 同形异义字。 用西里尔字母 а 代替拉丁字母 a,用希腊字母 ο 代替 o。NFKC 不会把这些折回去,它们确实是不同的字母,所以仍然是一个真实的缺口。同形替换还有一个用处:以后可以把形态规则指向它。
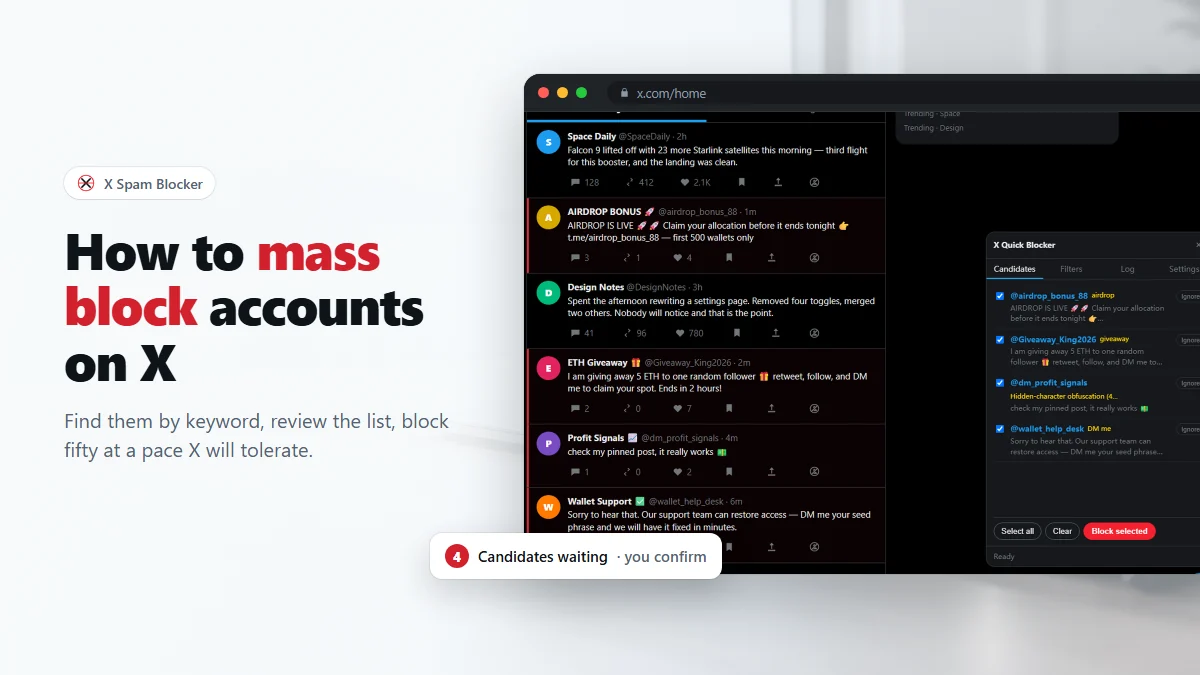
建在这些之上的过滤,见按关键词或正则屏蔽推特账号,或在 X 上屏蔽加密诈骗号和垃圾机器人里的现成列表。
常见问题
零宽字符是什么?
它们是真正的 Unicode 字符,渲染时不占宽度。存在是有正当理由的:把表情连在一起、控制波斯文和天城文字母如何连接、标记文字方向。但因为它们看不见,而且复制粘贴不会丢掉,也就成了拆掉文本过滤的方便办法。
X 自己能识别这个吗?
X 显然会过滤其中一部分,因为同样的垃圾常常最终会被删掉。但隐形字符在足够多的场合里是正当的,平台不能简单地把它们封掉;而一条垃圾回复只要活得够久、被人看见,任务就已经完成了。你自己这一侧的过滤,不必等任何人。
剥掉隐形字符会破坏正常推文吗?
不会到你能注意到的程度,因为剥掉只发生在用于匹配的那份副本上,页面上的内容不会被改动。识别更严格:隐形填充规则使用的字符集故意排除了表情连接符和变体选择符,所以一条表情很多的推文不会因此被标出。
多大比例算混淆?
字符串里可疑的隐形字符达到 30% 或更多,并且至少有 6 个,文本还要至少 8 个字符长。实测的垃圾回复落在 53–60%。普通推文,包括塞满表情和旗帜的,测出来是 0。
为什么日志里显示的是一个百分比,而不是关键词?
因为没有关键词命中。这条推文是因形态被标出的。日志会显示「隐形字符混淆」,并带上测得的比例,告诉你触发的是形态规则,而不是你自己的某一条。
确认之后,在 X 上批量屏蔽垃圾号
免费 Chrome 插件。无需账号、没有服务器、没有追踪。